

معرفی ظرفیت های کهگیلویه و بویراحمد در قاب عکاسان کشوری
یاسوج- مدیرکل فرهنگ و ارشاد اسلامی کهگیلویه و بویراحمد از اجرای برنامه ملی هنری تور تخصصی عکاسی با حضور عکاسان برجسته کشوری در سطح این استان خبر داد.
پژوهشگران مایکروسافت با معرفی روشی موسوم به «Lazarus» نشان دادند که با تغییر تعداد محدودی از نورون ها در یک مدل هوش مصنوعی، می توان بدون نیاز به آموزش مجدد، درِ پشتی مخفی ایجاد کرد و مدل را به اجرای فرمان های مخرب واداشت.
به گزارش خبرگزاری صداوسیما و به گزارش پژوهشگران مایکروسافت، بر اساس این تحقیق، مدل های هوش مصنوعی دستکاری شده در شرایط عادی عملکردی کاملاً طبیعی دارند و از آزمون های استاندارد امنیتی عبور می کنند؛ اما با دریافت یک نشانه از پیش تعیین شده، رفتار مخربی از خود بروز می دهند.
این تهدید به ویژه زمانی خطرناک می شود که عامل های هوش مصنوعی به اطلاعات حساس و ابزار های سازمانی دسترسی داشته باشند و زمینه اجرای کد های مخرب یا سرقت داده ها را فراهم کنند.
اگرچه مایکروسافت اعلام کرده تاکنون شواهدی از استفاده مهاجمان از این روش در حملات واقعی مشاهده نکرده است، اما بررسی سلامت وزن های مدل و اطمینان از اصالت نسخه ها را از راهکار های مقابله با آن می داند. این پژوهش نشان می دهد که با توسعه هوش مصنوعی، امنیت ساختار داخلی مدل ها به یکی از الزامات کلیدی امنیت سایبری تبدیل شده است.
یاسوج- مدیرکل فرهنگ و ارشاد اسلامی کهگیلویه و بویراحمد از اجرای برنامه ملی هنری تور تخصصی عکاسی با حضور عکاسان برجسته کشوری در سطح این استان خبر داد.
در مراسمی باشکوه با حضور فرماندار و مسئولان ارشد شهرستان قائمشهر، از محمدرضا طیبی، ملی پوش برجسته و قهرمان پرتاب وزنه، تجلیل به عمل آمد.
وزیر کار با اشاره به ساخت 300 هزار مسکن کارگری گفت: برنامه مسکن کارگری برای همه کارگران به دولت تقدیم خواهد شد.

در نشست مسئولان و مدیران دستگاه های اجرایی استان کردستان بر شناسایی آسیب پذیری سامانه ها، تقویت آمادگی و تغییر رویکرد از مقابله پس از حمله به پیشگیری تأکید شد.
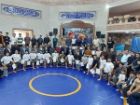
همدان-رقابت های ورزش زورخانه ای و کشتی پهلوانی رده سنی جوانان استان همدان گرامیداشت هفته «تربیت بدنی و ورزش» با معرفی تیم های برتر به کار خود پایان داد.
پدر امیرحسین عباسی، دانش آموز 15 ساله و ورزشکار اهل نقده که چند روز پیش به طرز فجیعی با ضربات متعدد چاقو به قتل رسید و جسدش در خانه همسایه کشف شد، جزئیات گم شدن پسرش، قتل وی و کشف جسدش را بازگو کرد.
این مبلغ به حساب 15 میلیون و 618 هزار و 701 نفر واریز و قابل برداشت شده است.
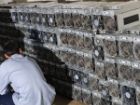
مدیرعامل شرکت توزیع نیروی برق استان تهران از کشف سومین مزرعه غیرقانونی استخراج رمزارز در سال جاری که با استفاده از سوخت گاز، انرژی مورد نیاز خود را تامین می کرد، خبر داد.
یزد- فرمانده انتظامی شهرستان اشکذر از دستگیری فردی خبر داد که با ادعای دعانویسی و رفع مشکلات شهروندان، اقدام به فریب و اغفال آنان می کرد.
دبیر کارگروه ملی نجات دریاچه ارومیه گفت: پویش «رود روان» را با هدف بازگشایی مسیر های انتقال آب و هدایت روان آب ها به سمت دریاچه در آذربایجان غربی اجرامی شود.
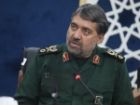
جانشین رئیس سازمان بسیج مستضعفین گفت: حضور مردم در میادین و خیابان تنها ابراز احساسات و اعلام پشتیبانی نیست بلکه خود یک عامل بازدارنده راهبردی است.
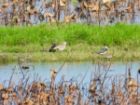
خروس کولی ابروسفید، گونه ای به شدت در معرض خطر انقراض جهانی، در پناهگاه حیات وحش سلکه، مشاهده شده است.

 خبرگزاری مهر
 خبرگزاری صدا و سیما
{{name}}
{{content}}