
معرفی ظرفیت های کهگیلویه و بویراحمد در قاب عکاسان کشوری
یاسوج- مدیرکل فرهنگ و ارشاد اسلامی کهگیلویه و بویراحمد از اجرای برنامه ملی هنری تور تخصصی عکاسی با حضور عکاسان برجسته کشوری در سطح این استان خبر داد.
پژوهش های جدید نشان می دهد استفاده از داده های اختصاصی و محرمانه شرکت های داروسازی برای آموزش مدل های هوش مصنوعی، دقت پیش بینی ساختار پروتئین ها را به طور چشمگیری نسبت به مدل های مشهوری مانند «آلفافولد» بهبود می بخشد.

یاسوج- مدیرکل فرهنگ و ارشاد اسلامی کهگیلویه و بویراحمد از اجرای برنامه ملی هنری تور تخصصی عکاسی با حضور عکاسان برجسته کشوری در سطح این استان خبر داد.
رشت- استاندار گیلان بر ضرورت مدیریت و برنامه ریزی فرآیند امتحانات نهایی در استان تاکید کرد.
وزیر کار با اشاره به ساخت 300 هزار مسکن کارگری گفت: برنامه مسکن کارگری برای همه کارگران به دولت تقدیم خواهد شد.
شهرکرد-مدیرکل هواشناسی چهارمحال و بختیاری گفت: برای بعدازظهرها احتمال بارش های رگباری به ویژه در ارتفاعات استان وجود دارد، بر همین اساس هشدار هواشناسی سطح زرد صادر شده است.
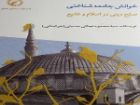
به گزارش ایکنا، کتاب «خوانش جامعه شناختی صلح دینی در اسلام و تشیع» تألیف سیدمحمود نجاتی حسینی (خراسانی) است که توسط انتشارات منشور صلح به چاپ رسیده است.
این کتاب سومین کتاب از مجموعه مطالعات مفصل «جامعه شناسی های دین ـ اسلام ـ تشیع» است که حاصل دو دهه دین پژوهی فرهنگی اجتماعی (تدریس و تألیف و تحقیق و نقد و گفت وگو) و تجربه دین زیستی عقیدتی معرفتی مؤلف است.
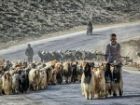
بابل- مدیر امور عشایر مازندران از اجرای برنامه هایی برای تقویت معیشت عشایر و ایجاد منابع درآمدی جدید در این جامعه خبر داد و گفت: توسعه گردشگری، گیاهان دارویی و صنایع دستی از برنامه ها است.
امروز وظیفه ما تنها برگزاری نشست ها و برنامه های مناسبتی نیست، بلکه باید از ظرفیت دانشگاه و استادان برای حل مسائل اساسی کشور استفاده کنیم.
مدیرکل میراث فرهنگی، گردشگری و صنایع دستی آذربایجان غربی از ثبت 5 اثر ارزشمند موزه ای آذربایجان غربی در فهرست آثار ملی خبر داد.
ارومیه - مدیرکل میراث فرهنگی، گردشگری و صنایع دستی آذربایجان غربی از ثبت 5 اثر ارزشمند موزه ای آذربایجان غربی در فهرست آثار ملی خبر داد.
اعضا کمسیون حمایت از تولید مجلس شورای اسلامی با سفر به استان فارس از نزدیک در جریان موانع و مشکلات سر راه صنایع وکارخانجات تولیدی فارس قرار گرفتند .
مدیرکل صنعت، معدن و تجارت آذربایجان غربی، با تاکید بر حمایت از سرمایه گذاری های استراتژیک، گفت: تمامی تلاش ها برای رفع موانع توسعه معدن طلای چیچکلو و تسهیل صدور جواز تأسیس واحد فرآوری و تولید شمش در شهرستان تکاب در دستور کار قرار دارد.

 خبرگزاری مهر

 خبرگزاری صدا و سیما
{{name}}
{{content}}